

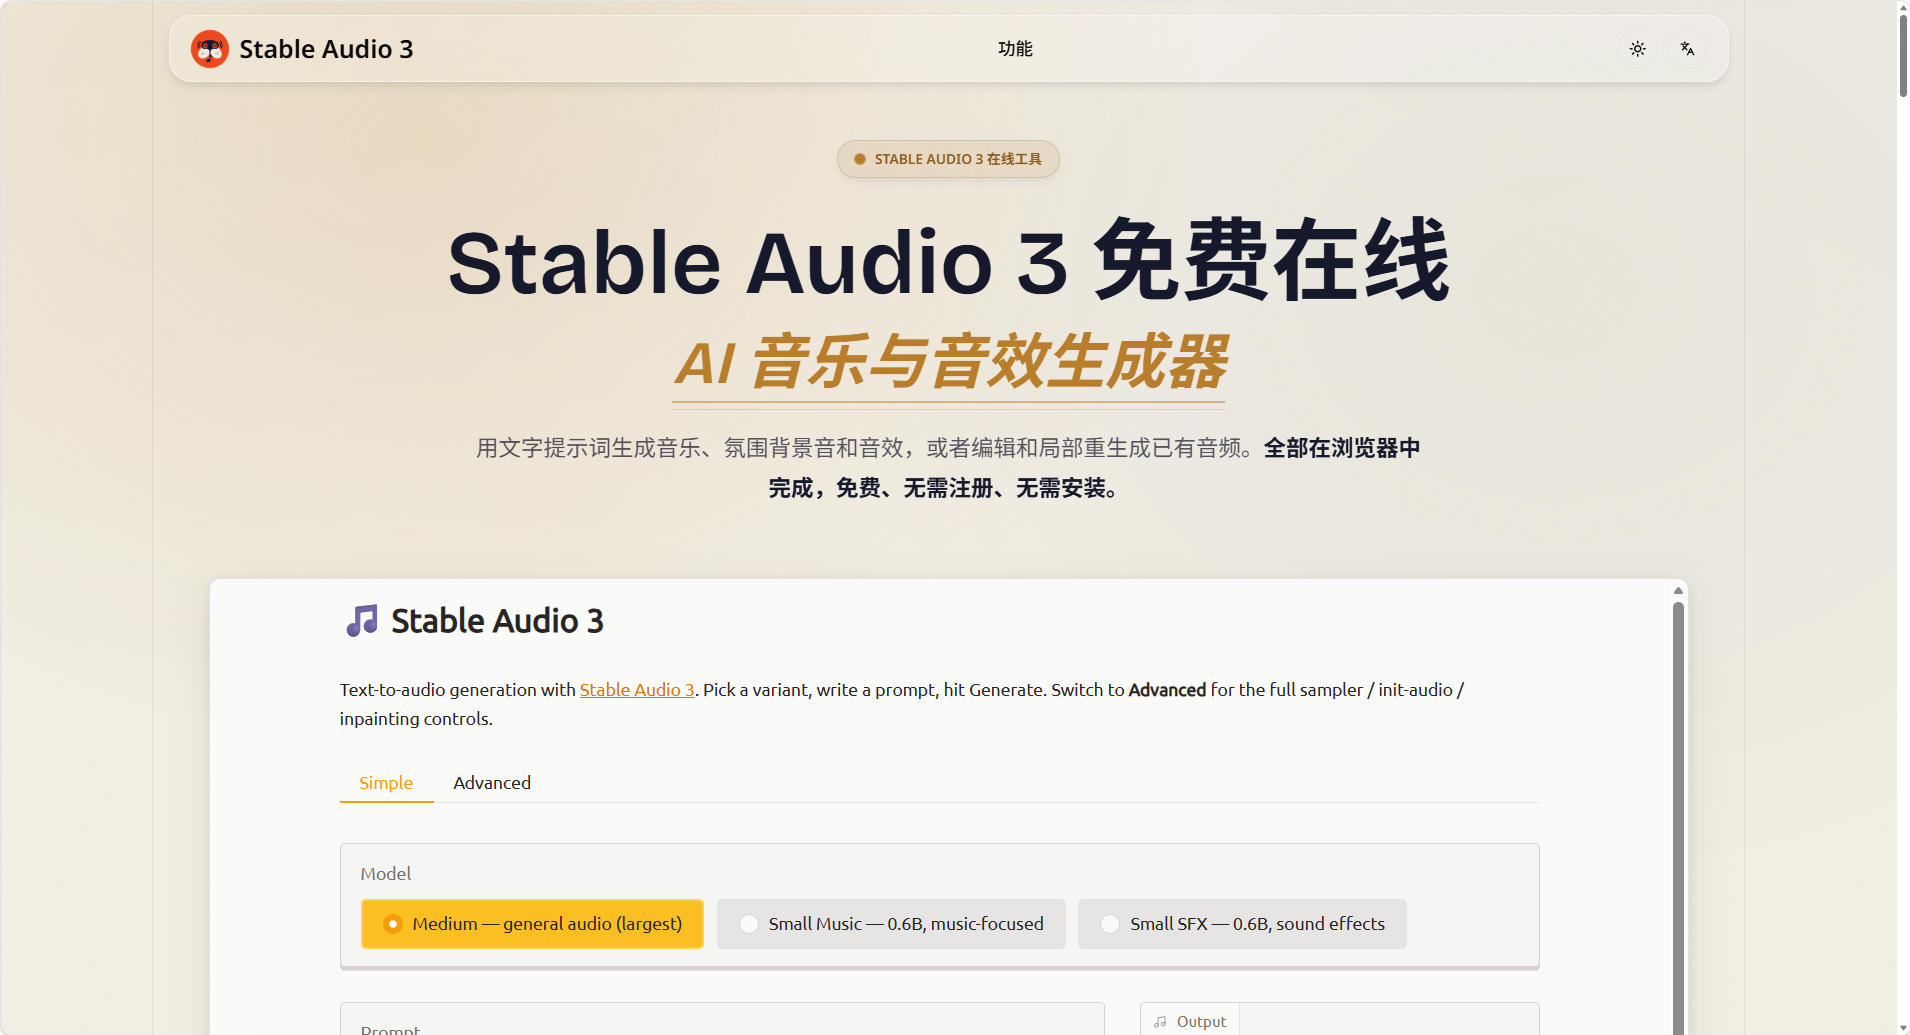
Stable Audio 3 是由 Stability AI 于 2026 年 5 月发布的开放权重 AI 音频生成模型家族。该工具支持根据文本提示词生成音乐、音效和氛围音,并提供音频编辑与局部重生成功能。
核心功能
适用场景
内容创作者:为 YouTube、TikTok 等视频生成匹配的背景音乐。
游戏开发者:使用 Small SFX 模型快速制作 UI 音效、环境音和战斗音效。
播客主:生成片头片尾音乐,或打磨背景音。
音乐人与制作人:快速将想法变成音频草图,以便导入专业软件继续创作。
主播与应用开发者:为直播、专注列表或冥想 App 生成长氛围背景音。
使用方式与注意事项
使用门槛极低,无需注册、无需安装、无需 GPU,直接在浏览器中即可免费使用。音频以 44.1 kHz 立体声 WAV 格式 输出,支持直接下载。
关于商业使用,Stability AI 表示,其输出可在 Stability AI Community License 下分发和商业化,超过收入门槛的组织需使用 Enterprise License。建议在正式商用前确认最新的官方条款。
©️版权声明:若无特殊声明,本站所有文章版权均归AI工具集原创和所有,未经许可,任何个人、媒体、网站、团体不得转载、抄袭或以其他方式复制发表本站内容,或在非我站所属的服务器上建立镜像。否则,我站将依法保留追究相关法律责任的权利。
类似网站


AI工具箱收录了国内外数百个不同类型的AI工具,每日更新和添加最新AI工具,AI工具集还推荐了AI学习开发的常用网站、框架和模型,帮助你加入人工智能浪潮,自动化高效完成任务!
Ctrl + D 或 ⌘ + D 收藏本站到浏览器书签栏。
 QQ群
 微信
 豫公网安备 41040202000300 号
暂无评论