

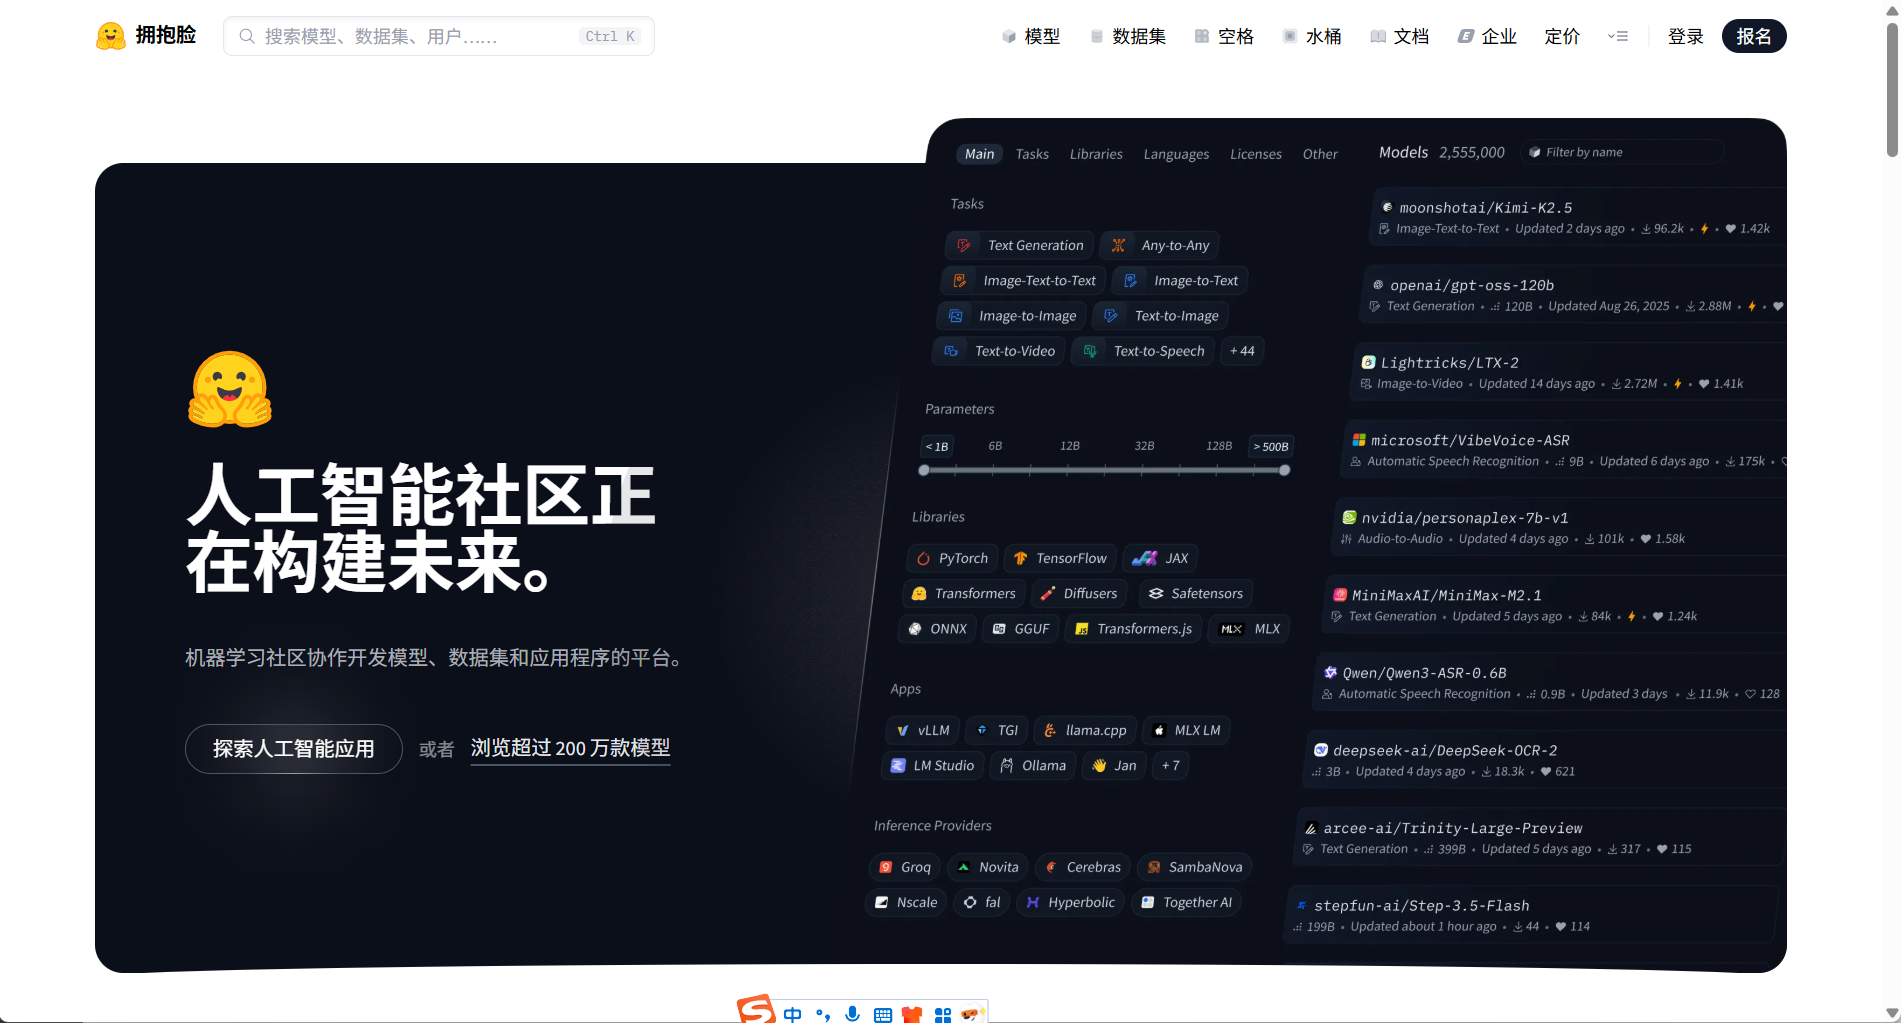
Hugging Face(昵称“抱抱脸”)是全球最大、最活跃的开源 AI 模型与数据集托管平台,被业界广泛誉为“AI 领域的 GitHub”。它本身并不研发前沿大模型,而是作为中立的枢纽,汇聚了全球开发者分享的模型、数据集与应用,极大地降低了 AI 技术的获取与使用门槛。2026 年 9 月,英伟达宣布以约 129.3 亿美元收购 Hugging Face,这一交易凸显了其作为 AI 开发生态基础设施的战略价值。
Hugging Face的主要功能
海量模型与数据集托管
平台的核心是 Hub,以 Git 仓库的形式托管了超过 300 万个模型和 50 万个数据集。模型覆盖自然语言处理、计算机视觉、语音、多模态等几乎所有 AI 任务。每个模型都配有 Model Card(模型说明卡),详细记录其用途、局限性、偏见和训练数据,帮助使用者负责任地评估和选择模型。
Spaces 交互式应用托管
Spaces 允许用户通过几行 Python 代码(基于 Gradio 或 Streamlit)或 Docker 部署,在浏览器中直接展示和体验 AI 模型的效果,无需本地配置环境。它既是开发者的作品集,也是与社区协作演示的便捷工具。
Transformers 等核心开源库
真正奠定 Hugging Face 地位的,是其开源的 Transformers 库。它提供了一套统一的 API,让开发者能用寥寥几行代码加载、微调和推理成千上万的预训练模型,彻底改变了此前每个新模型都需要重新搭建代码的混乱局面。此外,Datasets 库用于标准化数据加载,PEFT 用于高效微调,Accelerate 用于简化分布式训练,共同构成了完整的开发工具链。
推理与部署服务
平台提供 Inference API(无服务器推理),允许用户直接在浏览器或通过 API 测试模型效果。对于生产环境,Inference Endpoints 提供专属的托管推理服务,支持将模型部署到生产环境。
如何使用Hugging Face
注册与探索
访问官网注册免费账号即可浏览和下载大部分公开模型。注册的主要目的是为了下载需要接受许可的“门控模型”(如 Llama、Gemma 系列)、生成 API Token 以便通过代码或命令行访问,以及上传和分享自己的模型或 Spaces。
代码调用(Python)
在本地安装 transformers 和 huggingface_hub 库后,即可用代码加载模型。例如,加载一个情感分析模型并进行推理:
from transformers import pipeline
classifier = pipeline("sentiment-analysis")
result = classifier("I love using Hugging Face!")
print(result)
<svg xmlns="http://www.w3.org/2000/svg" width="12" height="12" viewBox="0 0 12 12" fill="none" class="_9bc997d _33882ae">
对于更复杂的任务,可以使用 AutoTokenizer 和 AutoModel 进行精细控制。
命令行工具
安装 huggingface_hub 包后,会附带 hf 命令行工具。你可以用它登录账号(hf auth login)、下载模型(hf download Qwen/Qwen3-0.6B)、上传文件或管理仓库,非常适合在终端或自动化脚本中使用。
创建与分享
登录后,你可以创建自己的模型仓库、数据集仓库或 Space,将训练好的权重和说明文档(Model Card)上传,与全球社区分享。上传的模型会自动获得一个可用的推理 API 页面。
Hugging Face的核心优势
生态标准与网络效应
Transformers 库的 API 已成为业界加载预训练模型的事实标准。模型数量与开发者规模形成了强大的网络效应:开发者越多,分享的模型越丰富;模型越丰富,越吸引开发者使用,使其地位难以被替代。
开源中立与社区信任
Hugging Face 本身不参与模型竞争,对 OpenAI、Meta、Google 等厂商的模型一视同仁。这种中立性使其成为整个 AI 生态的信任基石,开发者可以放心地将其作为技术选型和分发的中心。
从实验到生产的全链路支持
平台不仅提供模型发现和实验(Spaces、Inference API),还通过 Inference Endpoints、PEFT、Accelerate 等工具支持生产级部署与高效训练,覆盖了从原型验证到上线的完整生命周期。
对负责任 AI 的投入
通过 Model Card 和 Dataset Card 机制,平台鼓励开发者披露模型的局限性和偏见,推动了 AI 透明度和负责任使用的发展。
Hugging Face的应用场景
快速验证与原型开发
开发者可以在 Spaces 中直接体验他人部署的模型效果,或通过 pipeline 几行代码在本地跑通推理,快速验证某个模型是否满足业务需求,无需从零开始训练。
模型选型与对比
在模型库中按任务、框架、语言、许可证等条件筛选,查看下载量、点赞数和 Model Card 中的评测结果,对比不同厂商的模型(如 Llama、Qwen、Mistral)在特定任务上的表现。
模型微调与定制
利用 Transformers 和 PEFT 库,在自有数据上对预训练模型进行微调(如 LoRA),定制符合特定行业或场景需求的专属模型,并将微调结果分享回社区。
生产环境部署
通过 Inference Endpoints 将选定的模型部署为专属的、可自动扩缩容的推理服务,集成到应用后端,获得稳定的 API 访问能力。
学习与教学
丰富的模型、数据集和 Space 示例是学习 AI 的绝佳资源。学生和研究者可以下载模型和代码进行实验,或参考他人的 Space 实现来理解某个算法的实际效果。
类似网站
 QQ群
 微信
 豫公网安备 41040202000300 号
暂无评论